Retrieval-Augmented Generation — RAG Nedir?
Büyük dil modelleri neden bilmediğini uydurur? RAG’in ne olduğunu, nasıl çalıştığını, fine-tuning’den farkını ve nerelerde kullanıldığını örnekle anlatıyorum.
Giriş: Büyük dil modelleri neden “bilmediğini” uydurur?
ChatGPT, Claude veya Gemini gibi büyük dil modelleri (LLM) etkileyici cevaplar verir, ama iki temel sınırları vardır. Birincisi, bilgileri eğitildikleri tarihte donar; dün çıkan bir haberi ya da şirketinizin geçen hafta yayımladığı dokümanı bilemezler. İkincisi, bilmedikleri bir konuda bile akıcı ve emin bir dille cevap üretebilirler. Bu duruma halüsinasyon denir.
Örneğin bir modele şirketinizin izin politikasını sorarsanız, o politikayı hiç görmediği için genel geçer bir cevap uydurabilir. Peki modele, cevap vermeden hemen önce doğru belgeyi okutabilsek? İşte RAG tam olarak bunu yapar.
Bu yazıda RAG’in ne olduğunu, nasıl çalıştığını, fine-tuning’den farkını ve nerelerde kullanıldığını sıfırdan ve sade bir dille anlatacağım.
RAG nedir?
RAG (Retrieval-Augmented Generation), Türkçesiyle “geri getirmeyle zenginleştirilmiş üretim”, bir dil modelinin cevap üretmeden önce dış bir bilgi kaynağından ilgili belgeleri bulup okumasını sağlayan bir yöntemdir. Model artık yalnızca hafızasına güvenmez; önüne konan güncel ve doğrulanabilir metne dayanarak cevap verir.
Adı üç parçadan oluşur:
- Retrieval (geri getirme): Soruyla ilgili belgeleri bir bilgi tabanından bulmak.
- Augmented (zenginleştirilmiş): Bulunan belgeleri modele verilen talimata (prompt) eklemek.
- Generation (üretim): Modelin bu belgelere dayanarak cevabı yazması.
En sevdiğim benzetme şu: Normal bir LLM, sınava kitapsız giren çok okumuş bir öğrenci gibidir; hatırladığını yazar, hatırlamadığını tahmin eder. RAG kullanan bir LLM ise açık kitap sınavına giren öğrencidir. Soruyu okur, kitapta ilgili sayfayı bulur ve cevabını o sayfaya dayandırır.
Kavram, 2020 yılında Meta AI (o zamanki adıyla Facebook AI Research) araştırmacıları Patrick Lewis ve ekibinin yayımladığı “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks” makalesiyle literatüre girdi. Makalede önceden eğitilmiş bir dil modeli, Wikipedia’dan oluşturulmuş bir vektör indeksiyle birleştirildi. Bu yapı, açık alan soru-cevap görevlerinde dönemin en iyi sonuçlarına ulaştı ve yalnızca kendi hafızasını kullanan modellere göre daha spesifik ve daha doğru metinler üretti.
RAG nasıl çalışır?
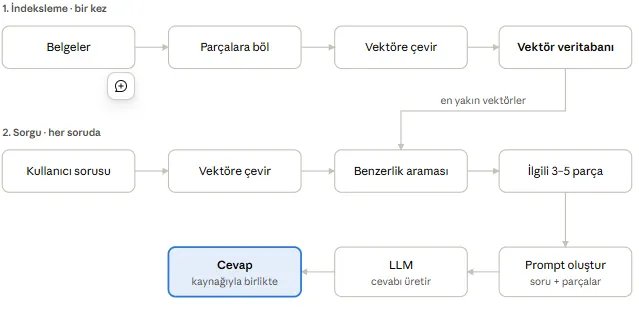
Bir RAG sistemi iki aşamadan oluşur: belgeleri bir kez hazırlayan indeksleme aşaması ve her soruda tekrarlanan sorgu aşaması.
Üst sıra belgeleri bir kez hazırlar; alt sıralar her soruda bu veritabanından ilgili parçaları çekip modele verir.
1. Aşama: İndeksleme (hazırlık)
- Belgeleri toplama: PDF’ler, web sayfaları, wiki yazıları, veritabanı kayıtları gibi kaynaklar bir araya getirilir.
- Parçalara bölme (chunking): Uzun belgeler, birkaç paragraflık küçük parçalara ayrılır. Model her seferinde koca bir kitabı değil, ilgili birkaç sayfayı okumalıdır.
- Vektöre dönüştürme (embedding): Her parça, bir embedding modeliyle sayılardan oluşan bir listeye, yani bir vektöre çevrilir. Bu vektör metnin anlamını temsil eder; anlamca yakın metinlerin vektörleri de birbirine yakın olur.
- Vektör veritabanına kaydetme: Vektörler, metinleriyle birlikte benzerlik araması için optimize edilmiş bir vektör veritabanında saklanır.
2. Aşama: Sorgu (her soruda)
- Soruyu vektöre çevirme: Kullanıcının sorusu, aynı embedding modeliyle vektöre dönüştürülür.
- Benzerlik araması (retrieval): Veritabanında soru vektörüne en yakın parçalar bulunur. Genellikle en alakalı 3–5 parça seçilir.
- Prompt’u zenginleştirme (augmentation): Bulunan parçalar soruyla birlikte tek bir talimatta birleştirilir: “Aşağıdaki bilgilere dayanarak soruyu cevapla.”
- Cevap üretme (generation): LLM, bu zenginleştirilmiş prompt’u okuyarak cevabı yazar; istenirse hangi belgeden yararlandığını da belirtir.
Embedding neden önemli?
Klasik arama, kelimelerin birebir eşleşmesine bakar. “Yıllık izin kaç gün?” diye aradığınızda, içinde “tatil hakkı” geçen bir belgeyi kaçırabilir. Embedding tabanlı anlamsal arama ise kelimelere değil anlama bakar; bu yüzden farklı sözcüklerle yazılmış ama aynı konuyu anlatan metinleri de bulabilir. Pratikte birçok sistem iki yaklaşımı birleştiren hibrit arama kullanır.
Basit bir örnek
Bir şirketin çalışanlara yönelik iç destek asistanı kurduğunu düşünelim. İnsan kaynakları yönetmeliği, IT kılavuzları ve masraf politikası sisteme yüklenmiş olsun.
Kullanıcı sorar: “Evden çalışırken internet faturamı masraf olarak gösterebilir miyim?”
Get Mahmut Yahya ÇİTİL’s stories in your inbox
Join Medium for free to get updates from this writer.
Sistem arka planda şunları yapar:
- Soruyu vektöre çevirir.
- Vektör veritabanında arama yapar ve en yakın iki parçayı bulur: masraf politikasının “uzaktan çalışma giderleri” maddesi ve İK yönetmeliğinin hibrit çalışma bölümü.
- LLM’e şu prompt’u gönderir:
- Model, belgedeki kurala dayanan bir cevap yazar ve kaynağını gösterir: “Masraf Politikası Madde 4.2'ye göre…”
Model bu şirketin politikasını hiç eğitim verisinde görmedi. Yine de doğru cevabı verebildi, çünkü cevabın dayanağı tam o anda önüne kondu.
Aşağıdaki şirket belgelerine dayanarak soruyu cevapla.
Belgelerde cevap yoksa "Bu konuda bilgi bulamadım" de.

[Belge 1 – Masraf Politikası, Madde 4.2]: ...
[Belge 2 – İK Yönetmeliği, Hibrit Çalışma]: ...

Soru: Evden çalışırken internet faturamı masraf olarak gösterebilir miyim?
RAG mı, fine-tuning mi?
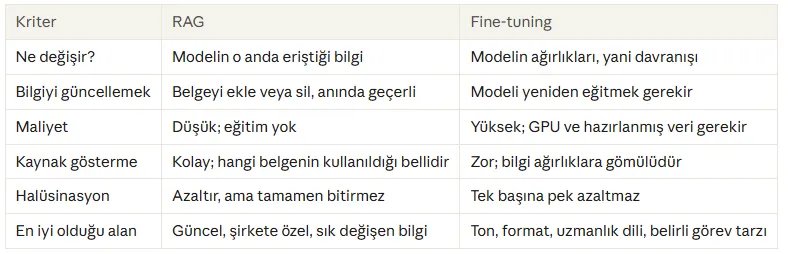
Modeli kendi verinizle konuşturmanın diğer bilinen yolu fine-tuning, yani modeli kendi verinizle yeniden eğitmektir. Kısa cevap: modelin neyi bildiğini değiştirmek istiyorsanız RAG, nasıl davrandığını değiştirmek istiyorsanız fine-tuning daha uygundur.
İkisi birbirinin rakibi değildir. Birçok gelişmiş sistem, belirli bir üslupla konuşacak şekilde fine-tune edilmiş bir modeli RAG ile birlikte kullanır.
Avantajlar ve sınırlamalar
Avantajlar
- Güncel bilgi: Bilgi tabanına yeni bir belge eklediğiniz anda model onu kullanabilir.
- Daha az halüsinasyon: Model cevabını somut bir metne dayandırdığı için uydurma ihtimali düşer.
- Şeffaflık: Cevabın hangi belgeden geldiği gösterilebilir; kullanıcı kaynağı kendisi kontrol edebilir.
- Gizlilik ve kontrol: Hassas veriler modelin içine gömülmez, sizin kontrolünüzdeki veritabanında kalır. Erişim yetkilerine göre filtreleme yapılabilir.
- Düşük maliyet: Modeli yeniden eğitmeye gerek yoktur.
Sınırlamalar
- Çöp girerse çöp çıkar: Geri getirme adımı yanlış belgeyi bulursa, model de yanlış cevap verir. Sistemin kalitesi büyük ölçüde arama kalitesine bağlıdır.
- Parçalama zordur: Çok küçük parçalar bağlamı kaybeder, çok büyükleri gereksiz bilgiyle doludur. Doğru boyutu bulmak deneme gerektirir.
- Bağlam penceresi sınırı: Modele aynı anda verilebilecek metin miktarı sınırlıdır; her şeyi prompt’a sığdıramazsınız.
- Ek gecikme: Arama adımı, cevap süresine küçük de olsa bir ek getirir.
- Halüsinasyon sıfırlanmaz: Model doğru belgeyi okusa bile onu yanlış yorumlayabilir. Bu yüzden değerlendirme (evaluation) ve test önemlidir.
Nerelerde kullanılır?
- Müşteri destek botları: Ürün dokümantasyonu ve SSS’lere dayanarak cevap verir.
- Kurumsal bilgi asistanları: Çalışanların iç wiki, yönetmelik ve proje dokümanlarında soru sormasını sağlar.
- Hukuk ve finans: Sözleşme, mevzuat veya raporlar içinde ilgili maddeleri bulup özetler.
- Sağlık ve araştırma: Güncel makale ve kılavuzlara dayalı bilgi sunar.
- Yazılım geliştirme: Kod tabanı ve API dokümanları üzerinden geliştiricilerin sorularını cevaplar.
Başlamak için popüler araçlar
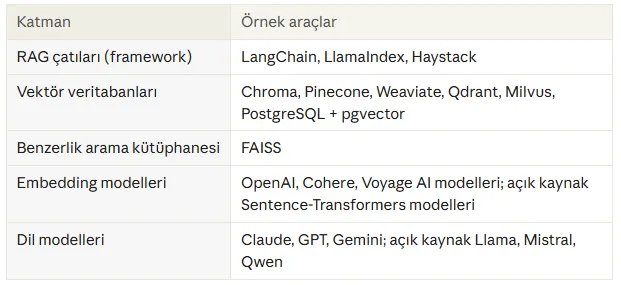
Yeni başlayanlar için en kolay yol: Python ile LangChain veya LlamaIndex kurmak, yerel çalışan Chroma veritabanını kullanmak ve birkaç PDF üzerinde soru-cevap denemek. Birkaç düzine satır kodla çalışan ilk RAG prototipinizi kurabilirsiniz.
Sonuç
RAG, büyük dil modellerinin en temel iki sorununa, yani eski bilgiye ve uydurmaya karşı pratik ve ucuz bir çözüm sunar. Mantığı basittir: modele cevap vermeden önce doğru belgeyi okut. Bu sayede model hem güncel kalır hem de cevabının kaynağını gösterebilir.
Bugün kurumsal yapay zekâ uygulamalarının büyük kısmının arkasında bir şekilde RAG vardır. Bir sonraki adım olarak hibrit arama, yeniden sıralama (reranking) ve modelin aramayı kendi başına yönettiği “agentic RAG” gibi ileri konulara bakabilirsiniz. Ama önce küçük bir prototip kurup birkaç belgenizle denemenizi öneririm; RAG’i en iyi, çalışırken görerek anlarsınız.
Kaynaklar
- Lewis, P. ve diğ. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020.
Teşekkürler
- Konuyla alakalı öncü ve yönlendirici tavrıyla meslektaşım Ahmet Tuğra Özdemir’e teşekkür ederim.
Bu yazı ilk olarak Medium’da yayımlandı.